CV
Education
- B.S. in GitHub, GitHub University, 2012
- M.S. in Jekyll, GitHub University, 2014
- Ph.D in Version Control Theory, GitHub University, 2018 (expected)
Work experience
- Summer 2015: Research Assistant
- Github University
- Duties included: Tagging issues
- Supervisor: Professor Git
- Fall 2015: Research Assistant
- Github University
- Duties included: Merging pull requests
- Supervisor: Professor Hub
Skills
- Skill 1
- Skill 2
- Sub-skill 2.1
- Sub-skill 2.2
- Sub-skill 2.3
- Skill 3
Publications
Presentations
Averaged Heavy Ball Method
Poster at Traditional Youth School “Control, Information and Optimization”, Voronovo, Russia
Averaged Heavy Ball Method
Talk at 62nd Scientific Conference at MIPT, Section “Data Analysis, Recognition and Prediction”, Dolgoprudny, Russia
Determination of Data Complexity Using a Universal Approximating Model
Talk at Mathematical Methods for Pattern Recognition: the 19th Russian National Conference with International Participation, Moscow, Russia
Random Reshuffling with Variance Reduction New Analysis and Better Rates
Talk at KAUST Conference on Artificial Intelligence 2021, Thuwal, Saudi Arabia
Random Reshuffling with Variance Reduction New Analysis and Better Rates
Poster at Traditional Youth School “Control, Information and Optimization”, Voronovo, Russia
Random Reshuffling with Variance Reduction New Analysis and Better Rates
Poster and Talk at Conference “Optimization Without Borders”, Sochi, Russia
Federated Random Reshuffling with Compression and Variance Reduction
Poster at International Workshop on Federated Learning for User Privacy and Data Confidentiality, ICML 2021, Online
Better Linear Rates for SGD with Data Shuffling
Poster and Talk at International OPT Workshop on Optimization for Machine Learning, NeurIPS 2021, Online
On Server-Side Stepsizes in Federated Optimization: Theory Explaining the Heuristics
Poster at International OPT Workshop on Optimization for Machine Learning, NeurIPS 2021, Online
ProxSkip: Breaking the Communication Complexity Barrier of Local Gradient Methods
Talk at Rising Stars in AI Symposium 2022 at KAUST, Thuwal, Saudi Arabia
Server-Side Stepsizes and Sampling Without Replacement Provably Help in Federated Optimization
Talk at Federated Learning One World Seminar (FLOW), Online
ProxSkip: Breaking the Communication Complexity Barrier of Local Gradient Methods
Talk at All-Russian Optimization Seminar, Online
ProxSkip: Yes! Local Gradient Steps Provably Lead to Communication Acceleration!
Talk at UCL CORE (Yurii Nesterov’s group) Optimization Seminar, Louvain-la-Neuve, Belgium
ProxSkip: Yes! Local Gradient Steps Provably Lead to Communication Acceleration! Finally!
Talk at Weierstrass Institute for Applied Analysis and Stochastics Stochastic Algorithms and Nonparametric Statistics group Seminar, Online
ProxSkip: Yes! Local Gradient Steps Provably Lead to Communication Acceleration! Finally!
Talk at CISPA Helmholtz Center for Information Security Seminar, Saarbrücken, Germany
ProxSkip: Yes! Local Gradient Steps Provably Lead to Communication Acceleration! Finally!
Talk at EPFL Machine Learning and Optimization Laboratory Seminar, Lausanne, Switzerland
ProxSkip: Breaking the Communication Complexity Barrier of Local Gradient Methods
Talk at 15th Viennese Conference on Optimal Control and Dynamic Games 2022, Vienna, Austria
On 5th Generation of Local Training Methods in Federated Learning
Talk at MIPT Intelligent Systems Seminar, Online
Can 5th Generation Local Training Methods Support Client Sampling? Yes!
Poster at Rising Stars in AI Symposium 2023 at KAUST, Thuwal, Saudi Arabia
Can 5th Generation Local Training Methods Support Client Sampling? Yes!
Poster at 26th International Conference on Artificial Intelligence and Statistics, Valencia, Spain
ProxSkip and its Variations: 5th Generation of Local Training Methods in Federated Learning
Talk at Google Research Seminar (invited by Zachary Charles), Online
Can 5th Generation Local Training Methods Support Client Sampling? Yes!
Talk at Third International Conference Mathematics in Armenia: Advances and Perspectives, Yerevan, Armenia
Random reshuffling with variance reduction: New analysis and better rates
Poster at 39th Conference on Uncertainty in Artificial Intelligence, Online
Server-side stepsizes and sampling without replacement provably help in federated optimization
Talk at 4th International Workshop on Distributed Machine Learning, Paris, France
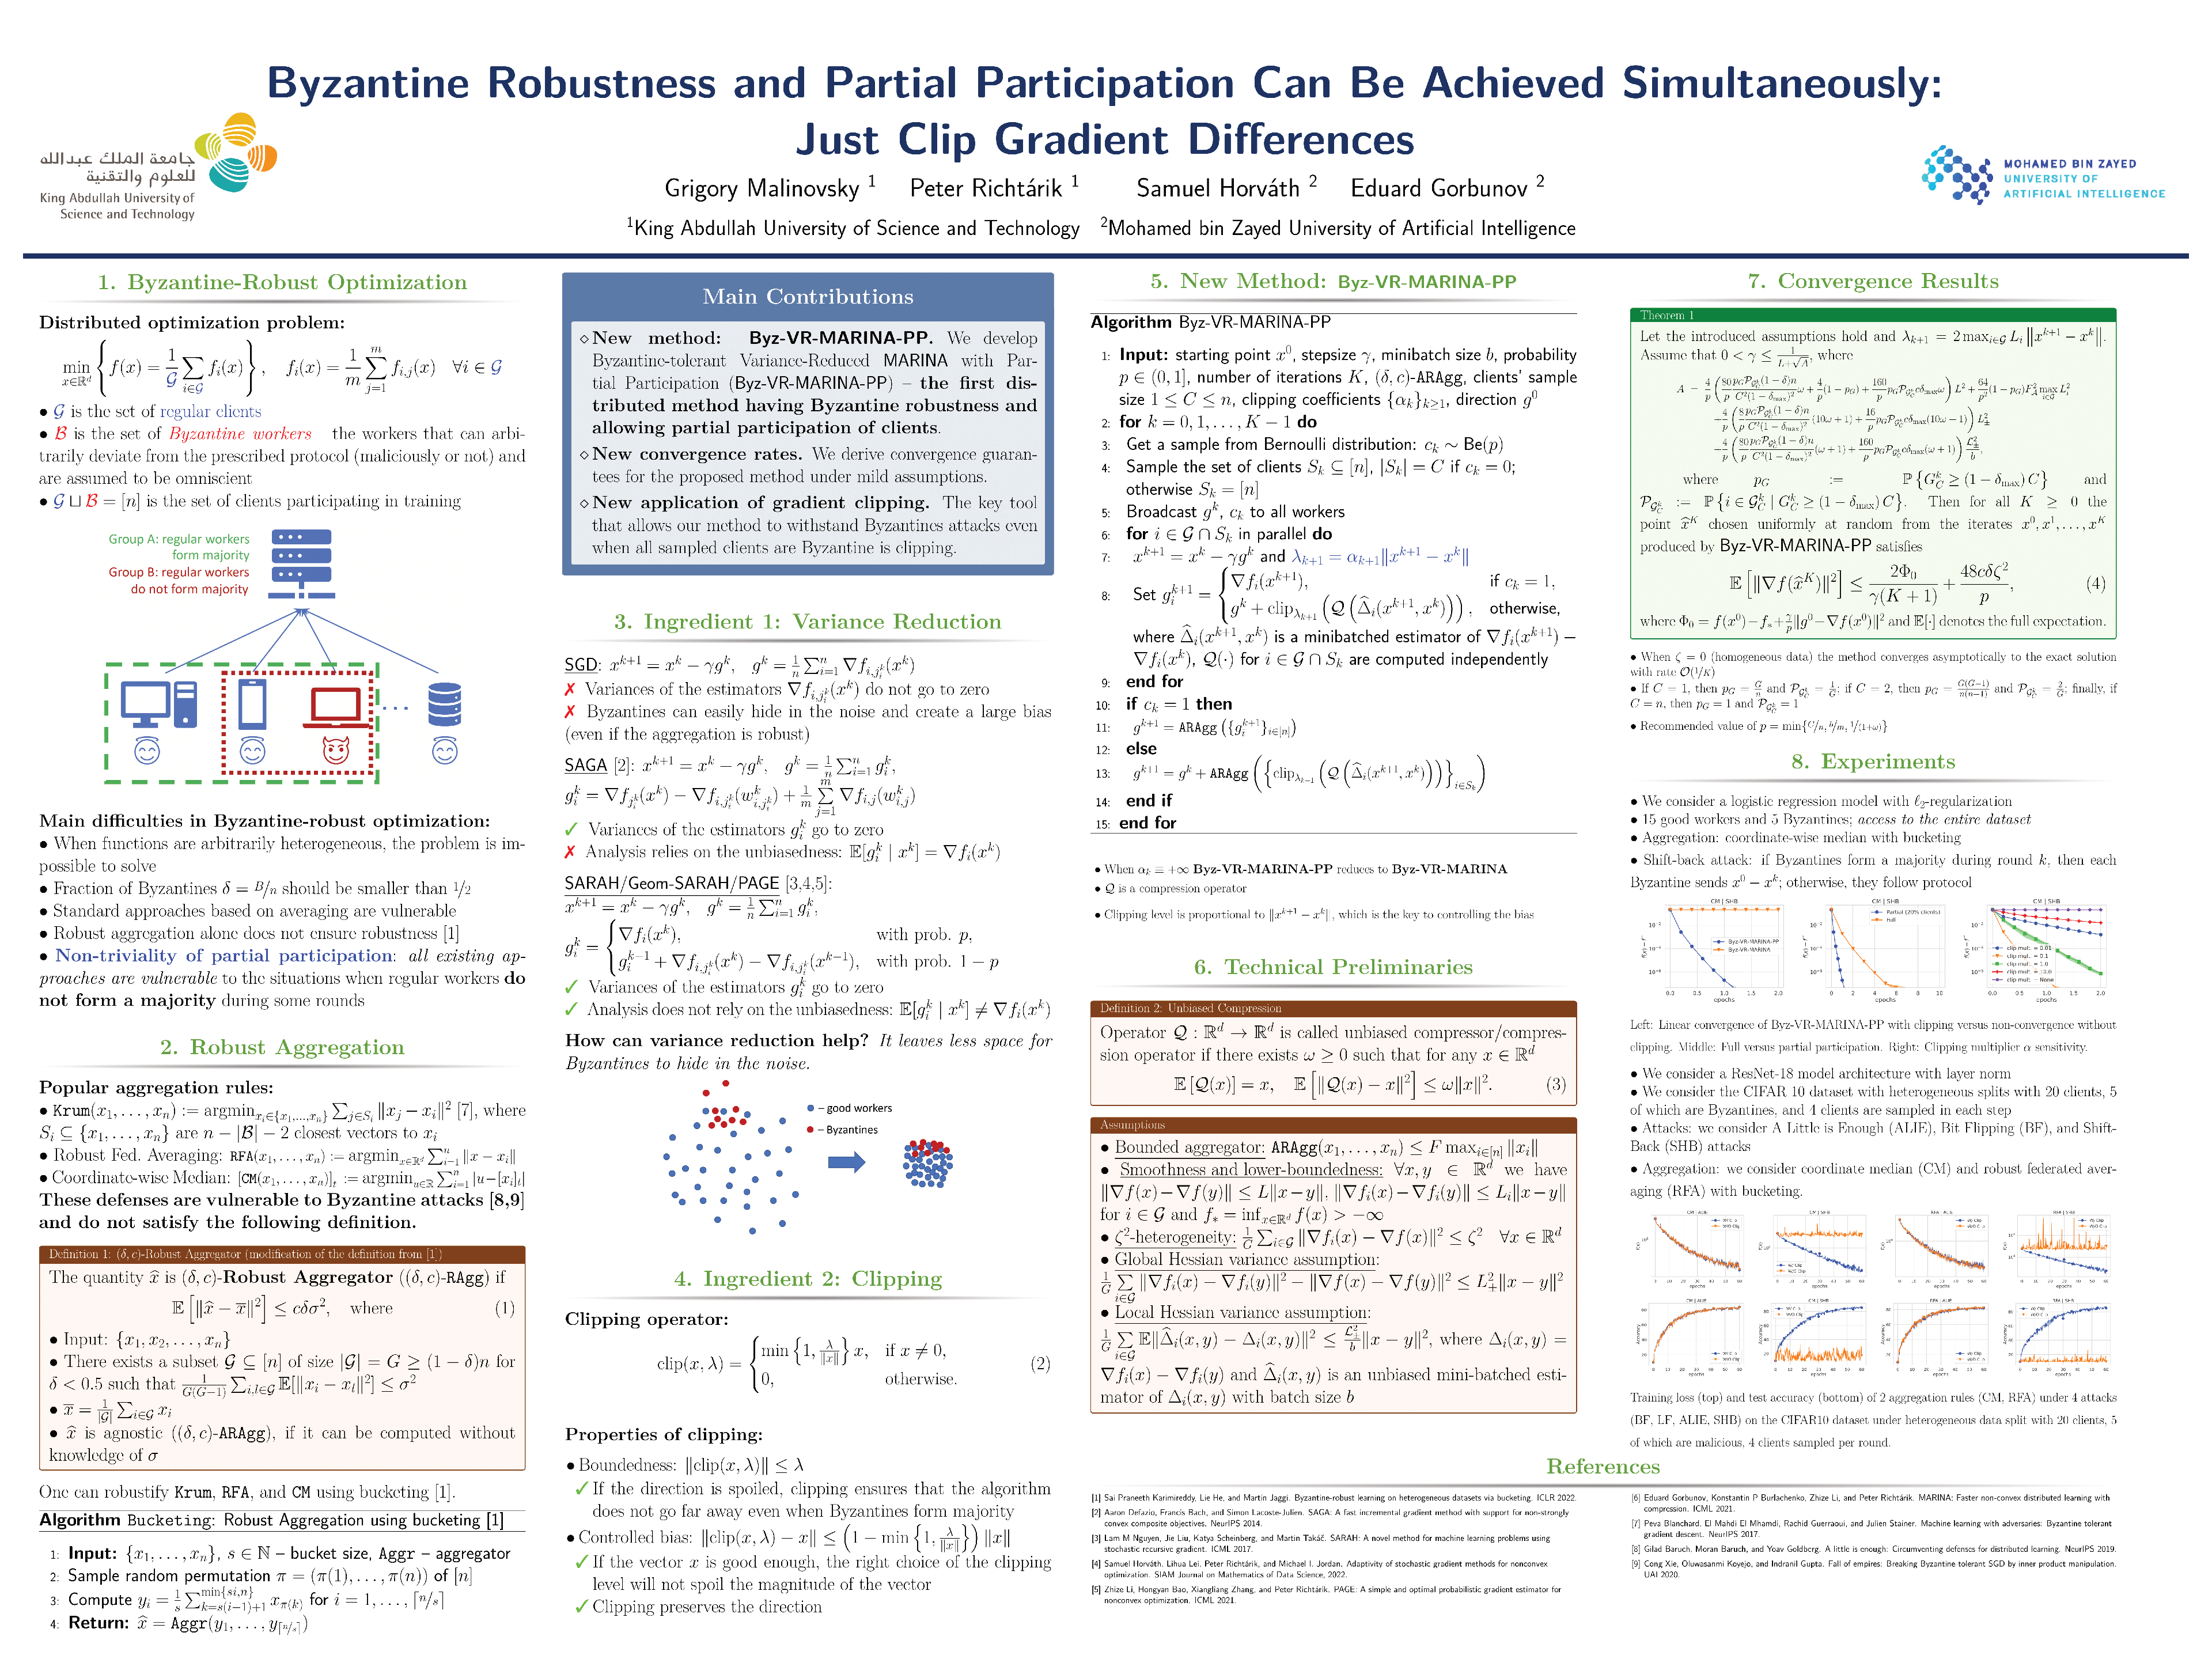
Byzantine Robustness and Partial Participation Can Be Achieved Simultaneously: Just Clip Gradient Differences
Poster at Rising Stars in AI Symposium 2024 at KAUST, Thuwal, Saudi Arabia
Byzantine Robustness and Partial Participation Can Be Achieved Simultaneously: Just Clip Gradient Differences
Talk at Federated Learning One World Seminar (FLOW), Online
Introduction to Federated Optimization
Talk at Samsung AI Reading Club, Staines, United Kingdom
Byzantine Robustness and Partial Participation Can Be Achieved Simultaneously: Just Clip Gradient Differences
Poster at 38th Annual Conference on Neural Information Processing Systems (NeurIPS 2024), Vancouver, Canada
Don’t Compress Gradients in Random Reshuffling: Compress Gradient Differences
Poster at 38th Annual Conference on Neural Information Processing Systems (NeurIPS 2024), Vancouver, Canada
MicroAdam: Accurate Adaptive Optimization with Low Space Overhead and Provable Convergence
Poster at 38th Annual Conference on Neural Information Processing Systems (NeurIPS 2024), Vancouver, Canada
MicroAdam: Accurate Adaptive Optimization with Low Space Overhead and Provable Convergence
Poster at Rising Stars in AI Symposium 2025, Thuwal, Saudi Arabia
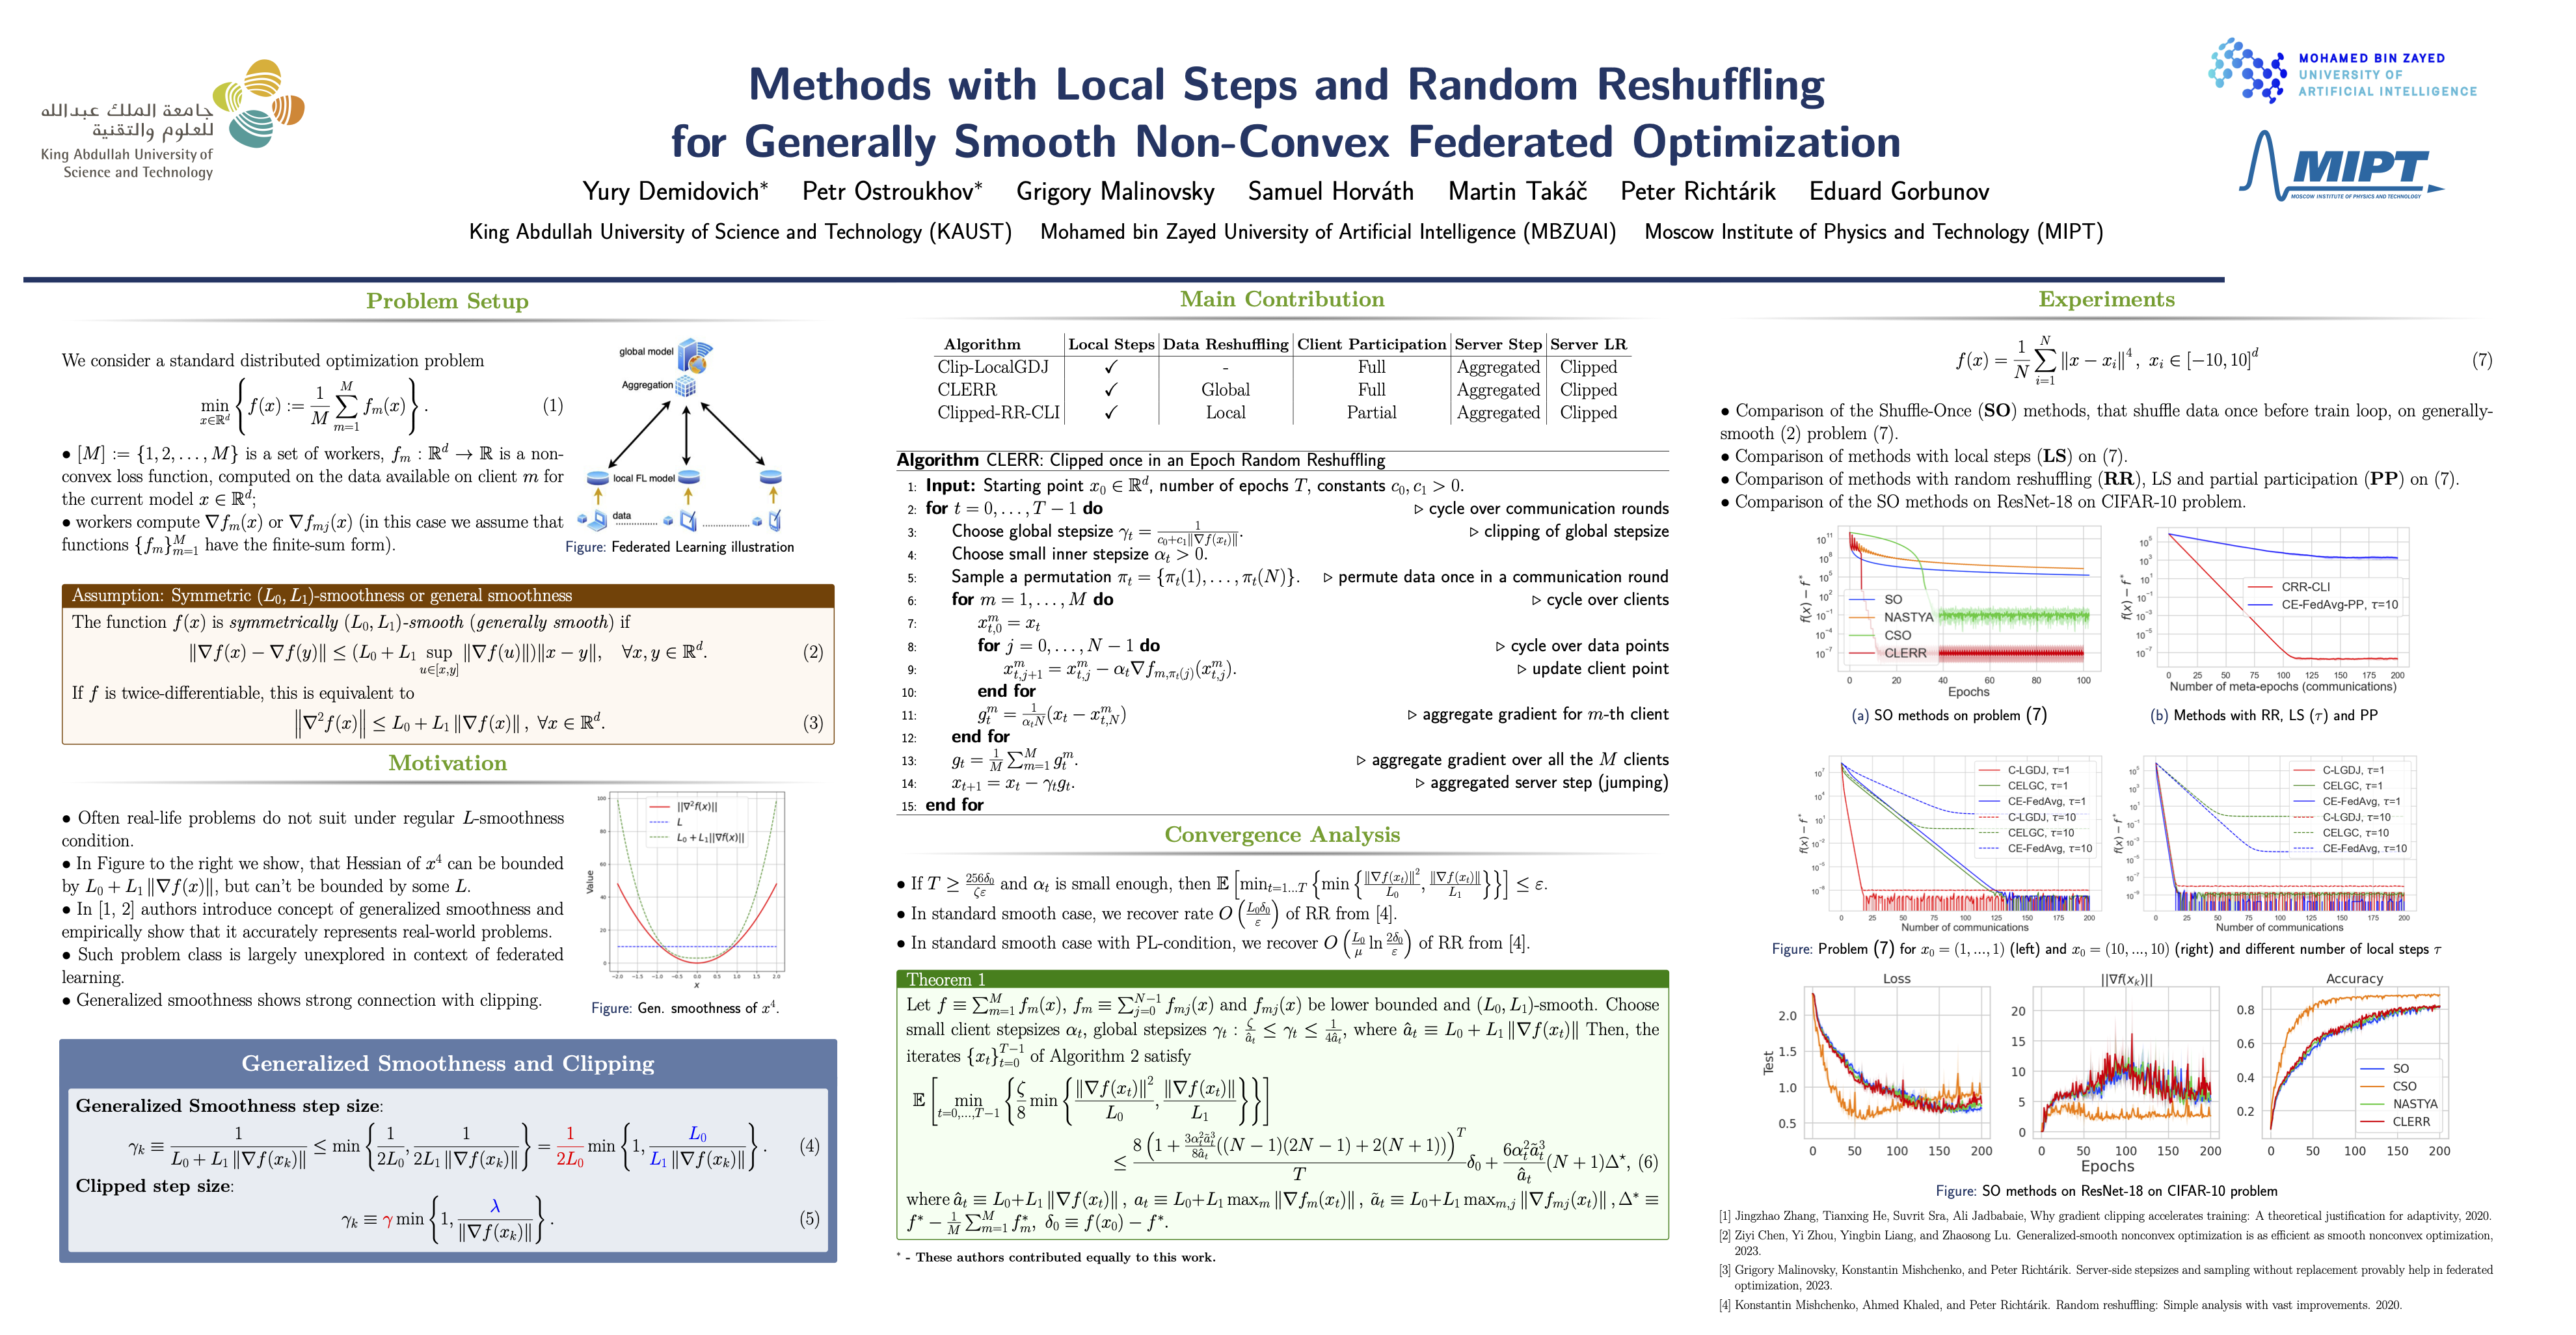
Methods with Local Steps and Random Reshuffling for Generally Smooth Non-Convex Federated Optimization
Poster at 13th International Conference on Learning Representations (ICLR 2025), Singapore
MAST: Model-Agnostic Sparsified Training
Poster at 13th International Conference on Learning Representations (ICLR 2025), Singapore
First Provable Guarantees for Practical Private FL: Beyond Restrictive Assumptions
Poster at Tiny Titans: The next wave of On-Device Learning for Foundational Models (Workshop at ICML 2025), Vancouver, Canada
Randomized Asymmetric Chain of LoRA: The First Meaningful Theoretical Framework for Low-Rank Adaptation
Poster at Tiny Titans: The next wave of On-Device Learning for Foundational Models (Workshop at ICML 2025), Vancouver, Canada
Improving Accelerated Federated Learning with Compression and Importance Sampling
Poster and Talk at International Conference on Computational Optimization (ICOMP 2025), Abu Dhabi, UAE
Streamlining in the Riemannian Realm: Efficient Riemannian Optimization with Loopless Variance Reduction
Poster and Talk at International Conference on Computational Optimization (ICOMP 2025), Abu Dhabi, UAE
Randomized Asymmetric Chain of LoRA: The First Meaningful Theoretical Framework for Low-Rank Adaptation
Talk at MBZUAI Stats seminar, Abu Dhabi, UAE
Randomized Asymmetric Chain of LoRA: The First Meaningful Theoretical Framework for Low-Rank Adaptation
Poster at KAUST Workshop on Distributed Training in the Era of Large Models, Thuwal, Saudi Arabia
Byzantine Robustness and Partial Participation Can Be Achieved Simultaneously: Just Clip Gradient Difference
Talk at USC CS Seminar, Los Angeles, USA
Parameter-Agnostic Error Feedback Enhanced With Hessian-Corrected Momentum
Poster at The 17th International Workshop on Optimization for Machine Learning (Workshop at NeurIPS 2025), San Diego, USA
Toward the First Optimization Framework for Low-Rank Adaptation
Poster at The 17th International Workshop on Optimization for Machine Learning (Workshop at NeurIPS 2025), San Diego, USA
First Provable Guarantees for Practical Private FL: Beyond Restrictive Assumptions
Poster at The 17th International Workshop on Optimization for Machine Learning (Workshop at NeurIPS 2025), San Diego, USA
Revisiting Stochastic Proximal Point Methods: Generalized Smoothness and Similarity
Poster at The 17th International Workshop on Optimization for Machine Learning (Workshop at NeurIPS 2025), San Diego, USA
Byzantine Robustness and Partial Participation Can Be Achieved Simultaneously: Just Clip Gradient Difference
Poster at Arizona State University EE Seminar, Tempe, USA
Byzantine Robustness and Partial Participation Can Be Achieved Simultaneously: Just Clip Gradient Difference
Poster at Rising Stars in AI Symposium 2026, Thuwal, Saudi Arabia
Byzantine Robustness and Partial Participation Can Be Achieved Simultaneously: Just Clip Gradient Difference
Talk at University of Zurich group seminar, Zurich, Switzerland
Byzantine Robustness and Partial Participation Can Be Achieved Simultaneously: Just Clip Gradient Difference
Talk at ETH ODI group seminar, Zurich, Switzerland
An Optimal Algorithm for Strongly Convex Min-min Optimization
Talk at Swiss Optimization Symposium, Ascona, Switzerland

Teaching
Service and leadership
- Currently signed in to 43 different slack teams