Communication-Efficient Federated Learning
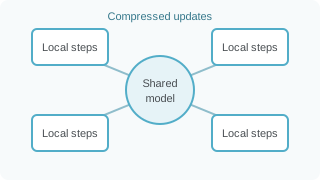
Communication is often a bottleneck when training a model across many devices. I study how local computation, compressed updates, and client sampling can reduce this cost while retaining convergence guarantees.
My work spans accelerated local training, random reshuffling, and compression, from ProxSkip and TAMUNA to communication-efficient methods for Muon-type optimizers.
Research focus
- Using local steps to reduce the number of communication rounds.
- Combining compression with variance reduction and random reshuffling.
- Supporting partial client participation in federated optimization.
Selected papers
ProxSkip: Yes! Local Gradient Steps Provably Lead to Communication Acceleration! Finally!
Thirty-ninth International Conference on Machine Learning (ICML 2022)
Uses local gradient steps to accelerate communication in federated optimization.
TAMUNA: Doubly Accelerated Federated Learning with Local Training, Compression, and Partial Participation
International Workshop on Federated Learning in the Age of Foundation Models (FL@FM-NeurIPS 2023)
Combines local training, compression, and partial participation with convergence guarantees.
Paper · arXiv · NeurIPS 2023 workshop · Cite
Don’t Compress Gradients in Random Reshuffling: Compress Gradient Differences
The Thirty-Eighth Annual Conference on Neural Information Processing Systems (NeurIPS 2024)
Studies compressed gradient differences in methods based on random reshuffling.
Paper · arXiv · ICML 2023 workshop · NeurIPS 2024 · Cite
Communication-Efficient Gluon in Federated Learning
arXiv · 2026
Analyzes compressed Muon-type methods for federated training.