Privacy and Robustness
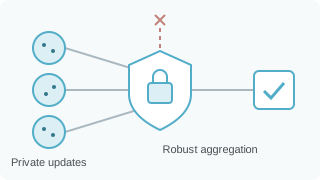
Keeping data on local devices does not, by itself, guarantee privacy, and distributed training must also account for faulty or malicious participants. I develop optimization methods with differential privacy and Byzantine-robustness guarantees.
I study how clipping, robust aggregation, local updates, and partial participation interact with convergence. Recent work also examines differential privacy for orthogonalized optimizers used in deep learning.
Research focus
- Private federated learning with local updates and client sampling.
- Byzantine-robust optimization under partial participation.
- Understanding the effects of clipping and privacy noise on optimization.
Selected papers
Byzantine Robustness and Partial Participation Can Be Achieved at Once: Just Clip Gradient Differences
The Thirty-Eighth Annual Conference on Neural Information Processing Systems (NeurIPS 2024)
Combines Byzantine robustness with partial client participation through gradient-difference clipping.
Paper · arXiv · Slides · ICLR 2024 workshop · NeurIPS 2024 · Cite
First Provable Guarantees for Practical Private FL: Beyond Restrictive Assumptions
The 17th Annual Workshop on Optimization for Machine Learning (OPT 2025, NeurIPS Workshop)
Provides privacy and convergence guarantees while supporting local updates and partial participation.
Paper · arXiv · ICML 2025 workshop · OPT 2025 · Cite
Byzantine-Robust and Differentially Private Federated Optimization under Weaker Assumptions
The 42nd Conference on Uncertainty in Artificial Intelligence (UAI 2026)
Studies Byzantine robustness and differential privacy together under weaker assumptions.
How Does Muon Work in Private Deep Learning? Scalable Differentially Private Training via Orthogonalization
arXiv · 2026
Examines differentially private training with orthogonalized optimizer updates.